
在讚、回覆、轉發這三個大家都看得到的數字裡,跟瀏覽次數關聯最強的是讚。我們用 2026 年 1 月 10 萬篇中文貼文算了兩次:相關係數裡,讚和瀏覽是 0.87,回覆 0.72,轉發 0.68;讓模型用這三個數字去猜瀏覽次數,它最依賴的也是讚。
但這不代表 Threads 的演算法就是「讚佔六成五」。這篇把兩種算法、程式碼和結果都攤開,最後再講這些數字能說明什麼、不能說明什麼。
先講結論
- 讚和瀏覽次數的關聯最強(0.87),回覆其次(0.72),轉發最弱(0.68)。
- 用隨機森林預測瀏覽次數,模型的判斷有 66% 靠讚,23% 靠回覆,12% 靠轉發。
- 這三個公開數字合起來,只能解釋瀏覽次數變化的一半左右。另一半來自看不到的因素,例如停留時間、帳號本身和內容。
- 這些都是關聯,不是演算法的權重。看到的人越多,讚自然越多,因果可能是反過來的。
- 實際能用的是「讚數 ÷ 瀏覽次數」這個比例:它比單看讚數更能看出內容有沒有打中人。
資料
Throk 整理了 2026 年 1 月 10 萬篇中文公開貼文,用的是發文一天後的讚、回覆、轉發和瀏覽次數。
社群數據非常不平均,少數爆文的數字是一般貼文的幾千倍,所以下面兩步都避開了會被極端值拉走的算法。
第一步:相關係數熱圖
相關係數衡量兩個數字是不是一起變大、一起變小。越接近 1,連動越強。
這裡用的是 Spearman 等級相關,而不是預設的 Pearson。Spearman 只看排名,不看實際數值,所以一篇破萬讚的爆文不會把整體結果拉歪。
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

# 一列一篇貼文,欄位:讚、回覆、轉發、瀏覽
df = pd.read_csv("threads_posts.csv")
cols = ["讚", "回覆", "轉發", "瀏覽"]

# Spearman 只看排名,不會被少數爆文拉走
corr = df[cols].corr(method="spearman")

plt.figure(figsize=(8, 6))
sns.heatmap(corr, annot=True, cmap="Blues", vmin=0.4, vmax=1, linewidths=0.5)
plt.title("讚、回覆、轉發和瀏覽次數的相關係數")
plt.savefig("correlation_heatmap.png", dpi=200, bbox_inches="tight")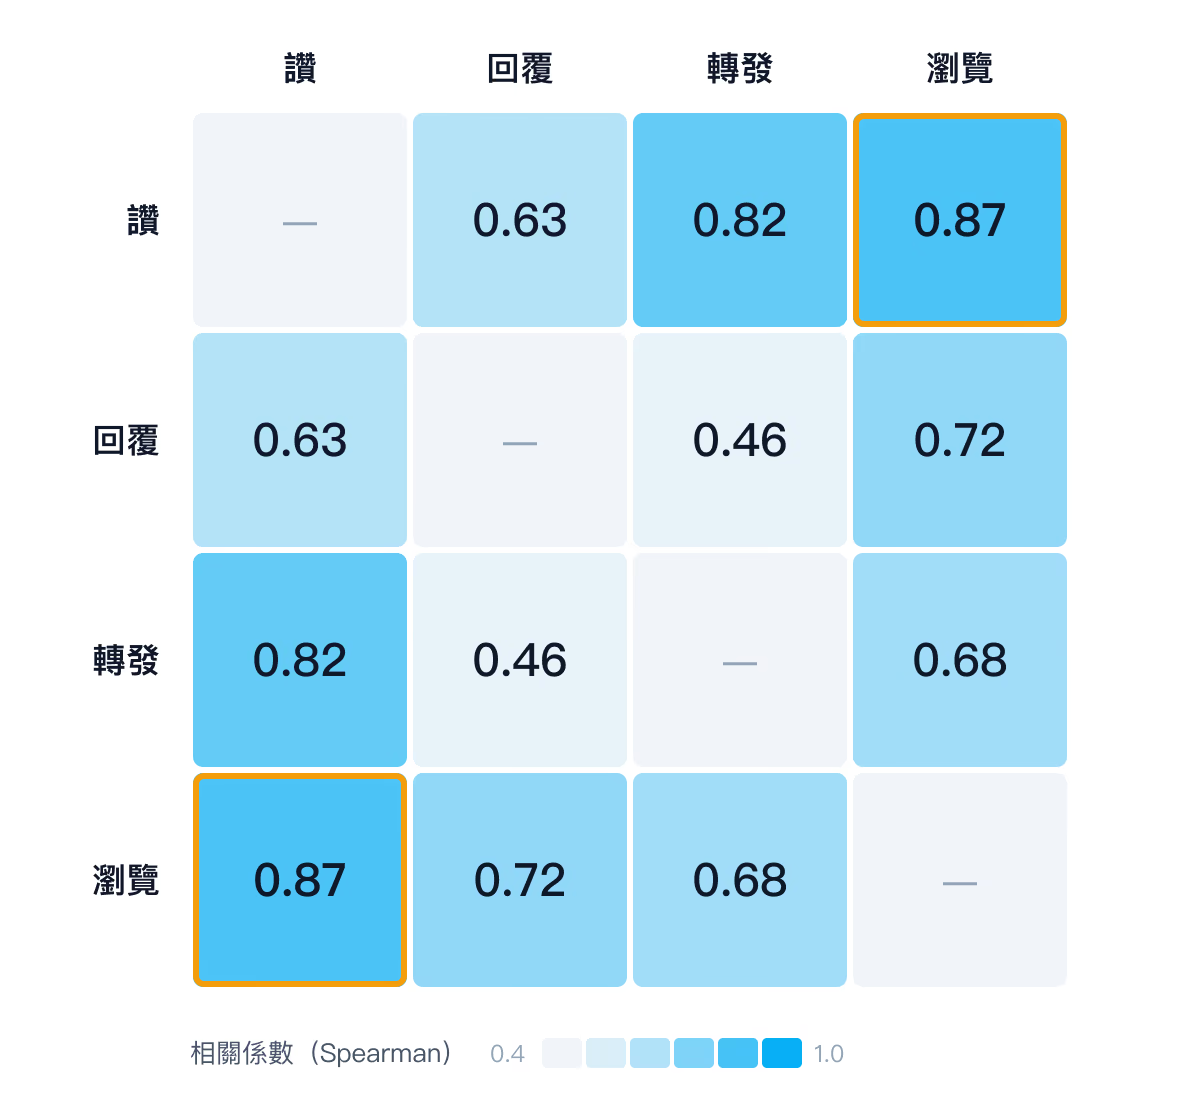
看最右邊那一欄:
- 讚 × 瀏覽 = 0.87:最高。按讚是成本最低的互動,看到的人越多,讚幾乎同步變多。
- 回覆 × 瀏覽 = 0.72:有關,但沒那麼緊。很多瀏覽很高的貼文,留言並不多。
- 轉發 × 瀏覽 = 0.68:三個裡最低。
另外兩格也值得看。讚 × 轉發 = 0.82,讓人想按讚的內容,通常也讓人想轉出去。回覆 × 轉發 = 0.46 是全表最低,引發討論的貼文和讓人想分享的貼文,常常不是同一種。
第二步:隨機森林
相關係數一次只看兩個數字。想知道三個數字一起看時,哪個對預測瀏覽次數最有用,可以讓模型來回答。
隨機森林是由很多棵決策樹組成的模型。我們把八成的貼文拿去訓練,讓它用讚、回覆、轉發去猜瀏覽次數,再用剩下兩成檢查它猜得準不準。
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score

X = df[["讚", "回覆", "轉發"]]
y = df["瀏覽"]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

rf = RandomForestRegressor(n_estimators=100, n_jobs=-1, random_state=42)
rf.fit(X_train, y_train)

importance = pd.Series(rf.feature_importances_, index=X.columns).sort_values(ascending=False)
print(importance)
print("R²:", r2_score(y_test, rf.predict(X_test)))
模型的「特徵重要性」:
| 公開數字 | 重要性 |
|---|---|
| 讚 | 65.6% |
| 回覆 | 22.8% |
| 轉發 | 11.6% |
模型猜瀏覽次數時,六成五的判斷靠讚。這和熱圖的排序一致。
測試資料上的 R² 是 0.535,意思是光靠這三個公開數字,大約只能解釋瀏覽次數變化的一半。剩下的一半,來自公開數字看不到的東西:讀者停留多久、有沒有點開看全文、帳號本身的追蹤者、發文時間,還有內容本身。
這些數字不能說明什麼
這段最重要,因為網路上很常把這類結果講成「讚的權重是轉發的 6 倍」。
這不是演算法的權重。 模型學的是「哪個數字最能幫它猜中瀏覽次數」,不是 Threads 怎麼決定要把貼文推給誰。Meta 公開說過,系統會預測讀者會不會按讚、留言、停留、點進作者檔案,但各項的權重沒有公開。官方說法整理在脆沒流量?先查這 7 件事。
因果可能是反過來的。 一篇貼文被推給越多人看,讚就越多。所以「讚多 → 瀏覽多」和「瀏覽多 → 讚多」,光看這些數字分不出來。
彼此相關的數字會互相分功勞。 讚和轉發的相關係數高達 0.82,模型只要抓住讚,就不太需要轉發了。轉發的重要性偏低,有一部分是被讚「搶走」的,不代表轉發沒用。在台灣的脆上,瀏覽最高的那批貼文,轉發加分享相對讚數的比例,反而比一般貼文高。
對經營有什麼用
- 看讚率,不只看讚數。 讚數會跟著瀏覽次數一起漲,單看讚數分不出是內容好,還是剛好被推出去。「讚數 ÷ 瀏覽次數」比較公平。一般貼文的讚大約是瀏覽次數的 1.5%,各級距的基準在脆的讚數、瀏覽次數多少算正常。
- 不要刻意衝留言或轉發。 蓋樓、互留做出來的數字,和真正會擴散的貼文長得不一樣。
- 開頭決定你拿到哪一種互動。 有些開頭特別容易拿讚,有些特別容易拿留言,實測數字在開頭句型的真實爆文機率。
用自己的數據跑一次
把自己貼文的數字整理成一個 CSV,一列一篇,欄位是「讚、回覆、轉發、瀏覽」,瀏覽次數可以從 Threads 的洞察報告抄。直接套用上面兩段程式碼,就能看到你的帳號是不是也一樣。
貼文太少的話,結果會很不穩,至少累積幾十篇再看。
常見問題
讚、回覆、轉發,哪個最重要?
如果是問「哪個跟瀏覽次數一起變動得最明顯」,答案是讚。但這是關聯,不是演算法給的分數。內容讓人想停下來、想按讚、想分享,三種互動通常會一起來。
為什麼用 Spearman,不用 Pearson?
社群數據有極少數爆文,數字是一般貼文的幾千倍。Pearson 會被這些極端值拉走,Spearman 只看排名,比較能反映一般貼文的情況。
隨機森林的特徵重要性,等於演算法的權重嗎?
不等於。特徵重要性說的是「模型猜瀏覽次數時最依賴哪個數字」。Threads 怎麼決定推薦誰,模型並不知道。
為什麼三個數字只能解釋一半的瀏覽次數?
因為影響瀏覽次數的很多因素,不會出現在公開數字裡,例如停留時間、帳號的追蹤者、發文時間和內容本身。
Threads 趨勢,寄進你的信箱
不定期整理成一封信:本週熱榜在紅什麼、哪種格式正在漲粉、值得卡位的發文時段。免費,隨時可退訂。
想把這些觀察,變成你的下一篇爆文?
免費開始使用